What's new
Markov Decision Process
Reinforcement Learning2026.10.24 22:10Markov Decision Process

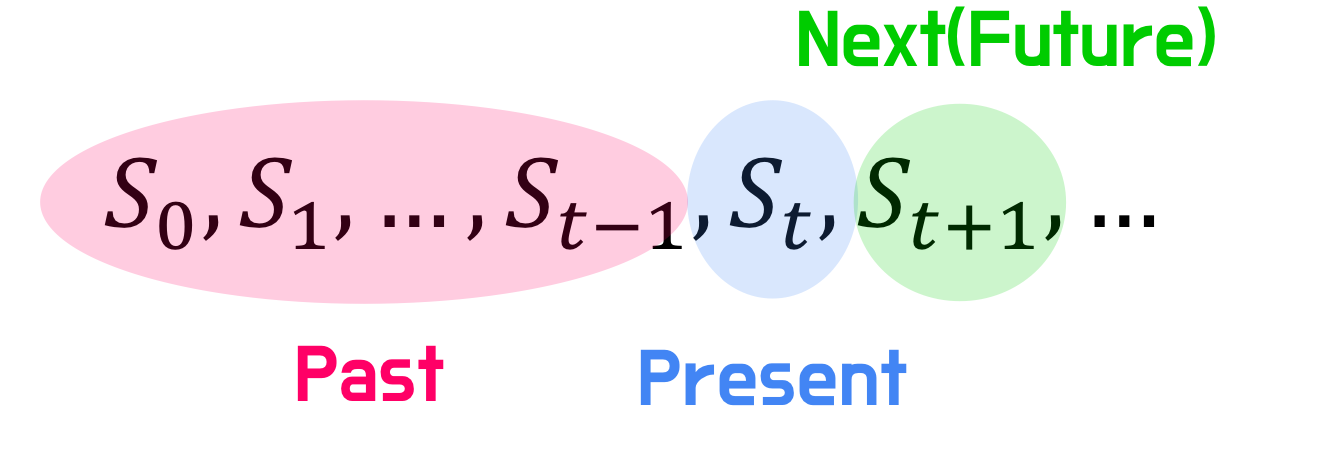
MDP는 매우 중요Grid World를 예시로 RL을 배우면 단순하면서도 이해하기가 편하다. Grid World Example 주어진 World가 Grid로 구성되어 있고 그 안에 로봇(Agent)이 있다고 가정합니다.로봇은 {위, 아래, 왼쪽, 오른쪽}으로 이동이 가능해요. 이런 World를 Grid World라고 지칭합니다. State$$S={(1, 1),(1, 2), (1, 3), ... , (4, 2), (4, 3)}$$ Action$$A = {N,S,E,W}$$ Reward큰 보상을오 보석에 도달하면 $+1$, 폭탄에 도달하면 $-1$빈칸에 대해서는 $c$만큼의 negative reward $S_0, A_0, R_0, S_1, A_1, R_1 ..$ 로 궤적을 표기할 겁니다. 각각의 St..
RL이 뭔데
Reinforcement Learning2026.10.24 20:35RL이 뭔데

https://youtube.com/shorts/usdH6FJ-p3k?si=uaOdoiNeRjkYHgT2 생각보다 넷플릭스처럼 돈을 주고 AI를 사용하는 사람은 극소수인가봐요.내 옆사람, 그 옆사람도 다 AI와 깊은 대화로 무언가를 만들어내고 해결해가나는 줄 알았지만그냥 저도 모르게 제 잣대를 들이밀고 있었는지도 모릅니다. 다시 생각해보면 제가 생물학과에 재학하고 있을 때에도 인공지능학을 전공하고 있는 학우들에 비하면 AI 사용에 있어서 상당히 위화감이 있었던 기억이 있습니다. 물론 이게 좋은 현상, 나쁜 현상 구별하자는게 아니지요. 시대적 움직임을 편협하게 보고 있던 제 자신을 고찰하고 관철하고 싶을 뿐. 단지 저를 비롯한 소수(?)의 개발자와 IT 직군 연구자들이 아둥바둥 경쟁하며 살아가는걸까요...
Stationary & Non-stationary Problem
Reinforcement Learning2026.10.24 20:30Stationary & Non-stationary Problem

Stationay Problem 정상 문제.보상의 확률 분포가 시간에 따라 변하지 않는 문제.이전 MAB는 stationary problem으로 볼 수 있습니다. Non-stationary Problem 비정상 문제.보상의 확률 분포가 시간에 따라 변하는 문제.주식이 이런 경우라 볼 수 있겠죠.같은 행동(매수, 매도)을 하더라도 시장 상황(경제 지표, 뉴스 등)에 따라 보상(수익 / 손실)이 계속 변하니까요. 하지만 헷갈리면 안됩니다.Stationary라도 같은 arm을 당겼을 때 30이 나오기도 27이 나오기도 하다는 건 당연합니다.분포 자체가 안변한다는 거죠. Non-stationary는 action을 취하고 났더니 분포가 바뀌는 상황을 말하는 겁니다. 평균이 30이었다가 70으로 바뀐 상황 같은..
Multi-armed Bandit | MAB
Reinforcement Learning2026.10.24 13:14Multi-armed Bandit | MAB

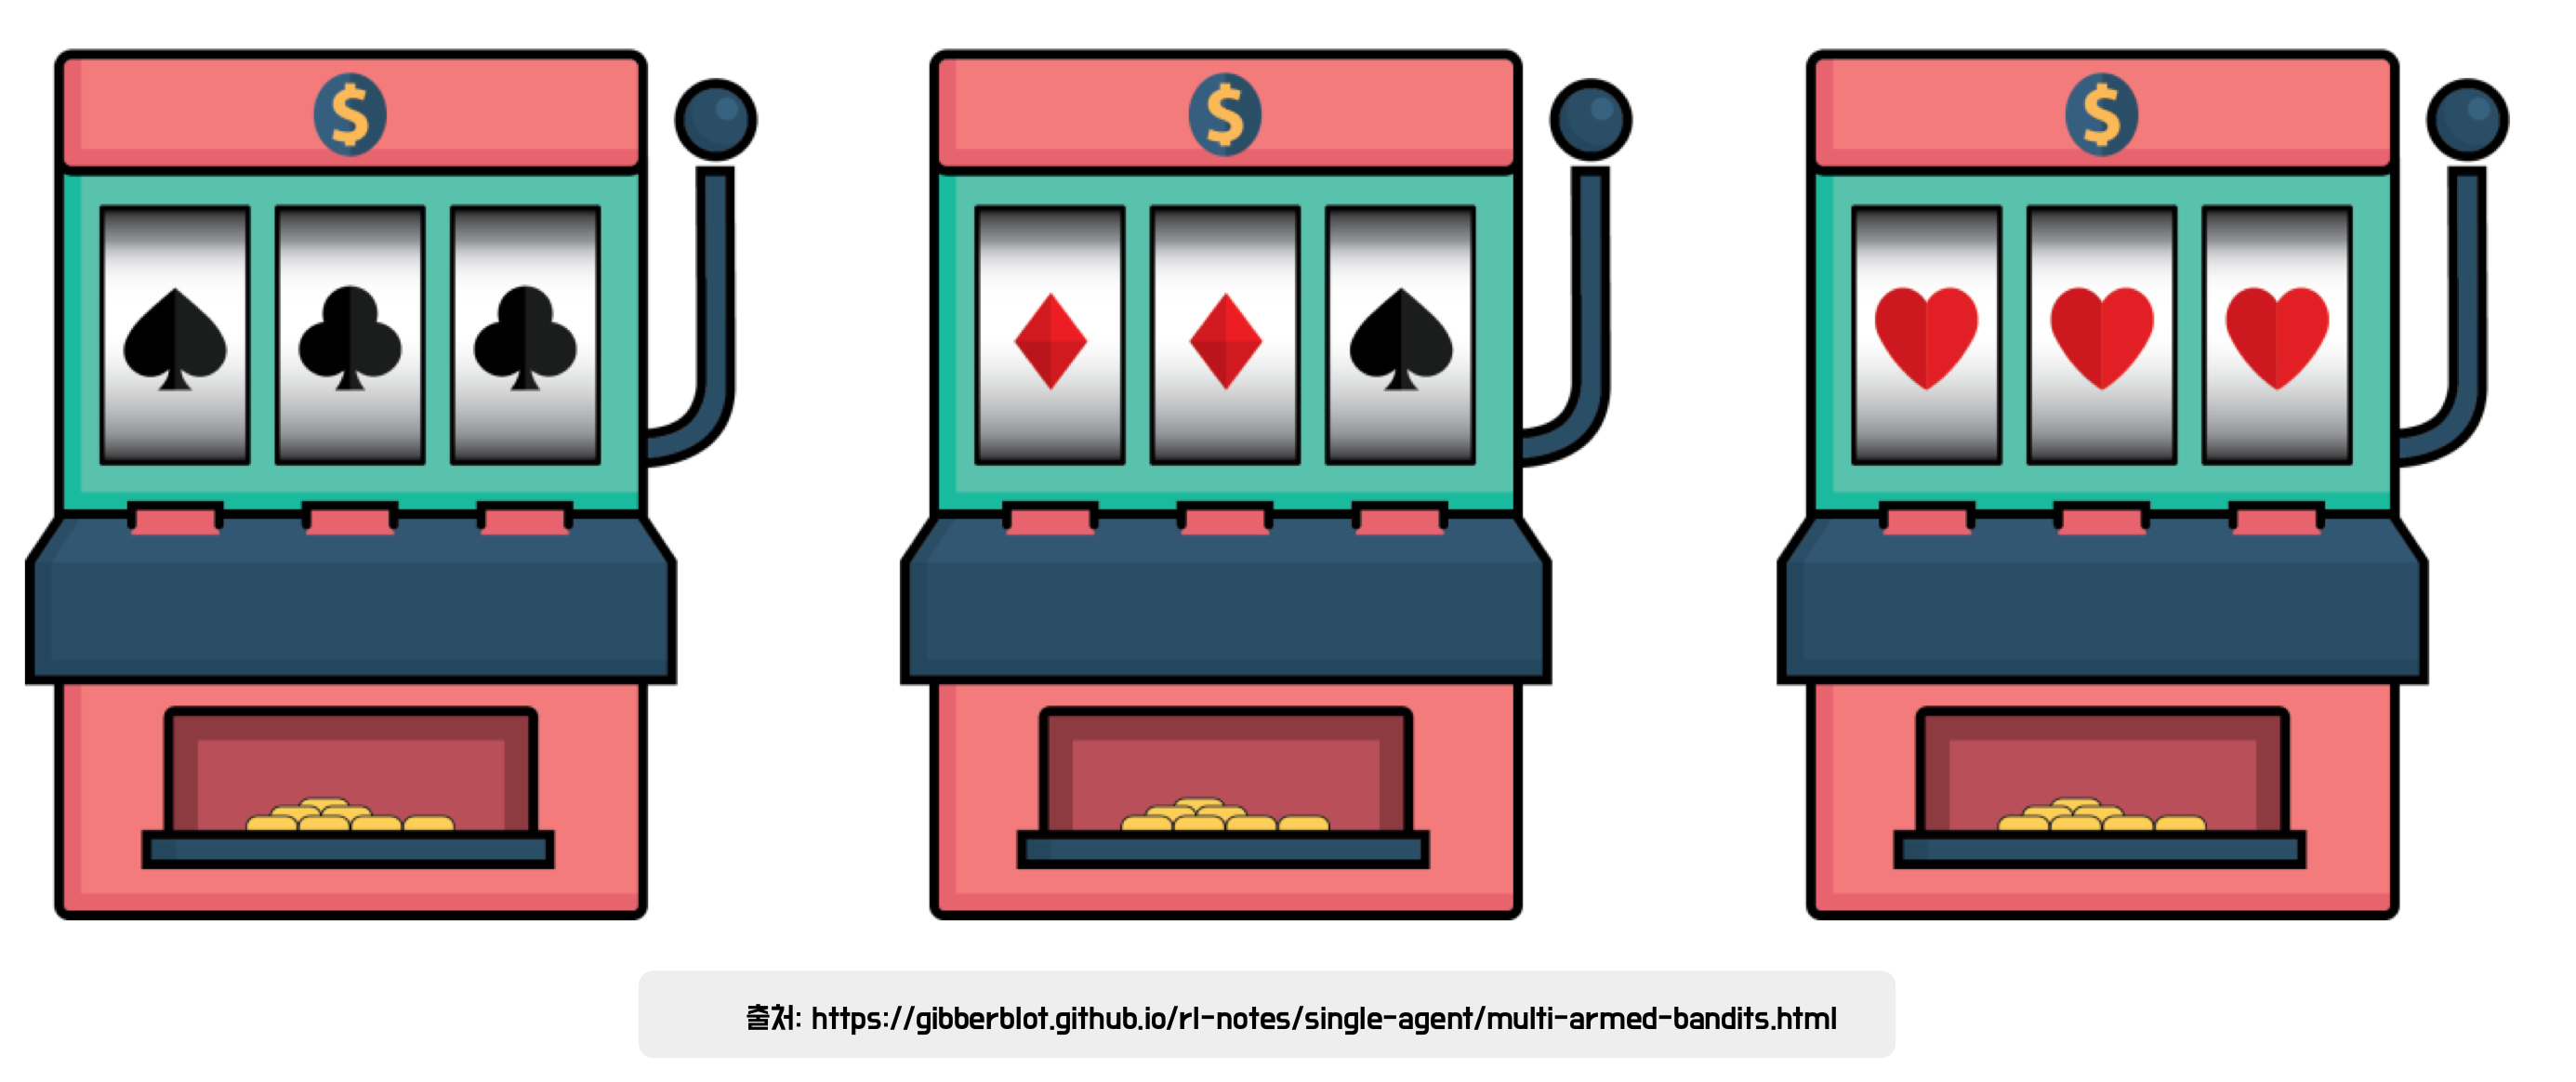
Exploitation | 활용지금까지 얻은 정보 중에서 가장 보상이 높을 것으로 예상되는 선택지를 반복적으로 선택하는 전략 Exploration | 탐색아직 충분히 알지 못하는 선택지를 시도해 보면서 새로운 정보와 기회를 발견하려는 전략 Exploitation만 수행하면 더 나은 선택을 놓칠 가능성이 있습니다.그래서 Exploration을 시도해 볼 필요가 생기죠. 가던 맛집만 가는 사람(Exploitation)이 있고안 가본 곳도 시켜보는 사람(Exploration)이 있죠. 당연히 trade-off가 있어요.어떤 arm을 당기면 최소 600점은 보장된다는 걸 아는데 더 높은 게 있지 않을까 이 기대 하나로 그 보장을 포기하고 다른 arm을 당겨볼 수 있어요. 탐색하면 더 나쁜 reward를 받을..
낭만
Gallery2026.10.18 22:24낭만

그 때만 할 수 있는게 있더랜다. 20대에만30대에만해볼 수 있는게 있더랜다. 오히려 이 말들이 더 서로를 비교하게 만드는게 아닌가 싶다.거기에 SNS가 더 불을 지피는 듯한. 방학이 되고 놀러가는 것, 좋지.밤새 술 진탕 먹고 다음 날 술 덜 깬 몸 이끌고 수업시간에 자는 것, 좋지. 요즘 이게 과연 정답인지 모르겠다. 대학생이니 미친듯이 공부하고,연구로 밤을 새고,상도 받아보고,지금 내 위치에서 오는 막막함에 울고, 이런 고생이 오히려 그시절 낭만이 아닌가.그래서 아프니까 청춘인건가.

Study Hard
Markov Decision Process
Reinforcement Learning
2026.10.24 22:10
MDP는 매우 중요Grid World를 예시로 RL을 배우면 단순하면서도 이해하기가 편하다. Grid World Example 주어진 World가 Grid로 구성되어 있고 그 안에 로봇(Agent)이 있다고 가정합니다.로봇은 {위, 아래, 왼쪽, 오른쪽}으로 이동이 가능해요. 이런 World를 Grid World라고 지칭합니다. State$$S={(1, 1),(1, 2), (1, 3), ... , (4, 2), (4, 3)}$$ Action$$A = {N,S,E,W}$$ Reward큰 보상을오 보석에 도달하면 $+1$, 폭탄에 도달하면 $-1$빈칸에 대해서는 $c$만큼의 negative reward $S_0, A_0, R_0, S_1, A_1, R_1 ..$ 로 궤적을 표기할 겁니다. 각각의 St..
RL이 뭔데
RL이 뭔데
Reinforcement Learning
2026.10.24 20:35
https://youtube.com/shorts/usdH6FJ-p3k?si=uaOdoiNeRjkYHgT2 생각보다 넷플릭스처럼 돈을 주고 AI를 사용하는 사람은 극소수인가봐요.내 옆사람, 그 옆사람도 다 AI와 깊은 대화로 무언가를 만들어내고 해결해가나는 줄 알았지만그냥 저도 모르게 제 잣대를 들이밀고 있었는지도 모릅니다. 다시 생각해보면 제가 생물학과에 재학하고 있을 때에도 인공지능학을 전공하고 있는 학우들에 비하면 AI 사용에 있어서 상당히 위화감이 있었던 기억이 있습니다. 물론 이게 좋은 현상, 나쁜 현상 구별하자는게 아니지요. 시대적 움직임을 편협하게 보고 있던 제 자신을 고찰하고 관철하고 싶을 뿐. 단지 저를 비롯한 소수(?)의 개발자와 IT 직군 연구자들이 아둥바둥 경쟁하며 살아가는걸까요...
Stationary & Non-stationary Problem
Reinforcement Learning
2026.10.24 20:30
Stationay Problem 정상 문제.보상의 확률 분포가 시간에 따라 변하지 않는 문제.이전 MAB는 stationary problem으로 볼 수 있습니다. Non-stationary Problem 비정상 문제.보상의 확률 분포가 시간에 따라 변하는 문제.주식이 이런 경우라 볼 수 있겠죠.같은 행동(매수, 매도)을 하더라도 시장 상황(경제 지표, 뉴스 등)에 따라 보상(수익 / 손실)이 계속 변하니까요. 하지만 헷갈리면 안됩니다.Stationary라도 같은 arm을 당겼을 때 30이 나오기도 27이 나오기도 하다는 건 당연합니다.분포 자체가 안변한다는 거죠. Non-stationary는 action을 취하고 났더니 분포가 바뀌는 상황을 말하는 겁니다. 평균이 30이었다가 70으로 바뀐 상황 같은..
Multi-armed Bandit | MAB
Reinforcement Learning
2026.10.24 13:14
Exploitation | 활용지금까지 얻은 정보 중에서 가장 보상이 높을 것으로 예상되는 선택지를 반복적으로 선택하는 전략 Exploration | 탐색아직 충분히 알지 못하는 선택지를 시도해 보면서 새로운 정보와 기회를 발견하려는 전략 Exploitation만 수행하면 더 나은 선택을 놓칠 가능성이 있습니다.그래서 Exploration을 시도해 볼 필요가 생기죠. 가던 맛집만 가는 사람(Exploitation)이 있고안 가본 곳도 시켜보는 사람(Exploration)이 있죠. 당연히 trade-off가 있어요.어떤 arm을 당기면 최소 600점은 보장된다는 걸 아는데 더 높은 게 있지 않을까 이 기대 하나로 그 보장을 포기하고 다른 arm을 당겨볼 수 있어요. 탐색하면 더 나쁜 reward를 받을..
[AI/SW] 소프트웨어 공학이란?
[AI/SW] 소프트웨어 공학이란?
Welcome to AI
2026.10.18 22:22
소프트웨어 공학(Software Engineer)은 대규모 팀이 오랜 기간 동안 변화 속에서 제품의 품질을 유지하는 체계적(systematic) 방법. 모든 것이 변한다. 고객의 마음, 사용자, 데이터, 환경이 바뀌는 상황에서 어떻게 체계적으로 개발할 것인가. 정의소프트웨어 공학: 소프트웨어를 어떤 방식으로, 어떻게 만들 것이가에 대한 공학적(종합적, 체계적) 접근개인의 코딩속도 / 실력 / 능력 $\rightarrow$ 대규모 팀이 오랜 기간 변화 속에서 제품 품질을 유지하는 방법예전에는 슈퍼 개발자 한 명에 의존하는 Heroic Development가 있었다. 5 - 10명 규모에선 통하기도 했으나, 수백-수천 명이 OS(Windows)나 수백만 transection 서비스(e.g. 카카오톡)..
<궁금증> On-policy vs Off-policy
Reinforcement Learning
2026.08.28 18:52
내가 지금 학습할 데이터를 누가, 어떤 상태(state)에서 모아왔는가? On-Policy내가 직접 부딪히며 싸운다. 현재 내 상태, 내 실력(현재의 policy)으로 직접 환경과 부딪혀가며 얻은 경험 데이터만 가지고 학습하는 방식 자전거 타는 법을 떠올리자.한 쪽으로 기울어 내가 넘어질 것 같은 느낌이 들 때, 상황에 맞게 핸들을 트는 판단. 직접 페달을 밟다가 비틀거리는 순간에 그 즉시 내가 수정해가며 배우는 방식이라 할 수 있다. 학생(Student) 모델이 사진이 부족해 자기 멋대로 엉성한 3D Gaussian을 만들고, 그 엉성한 상태에서 카메라를 돌려 렌더링을 해본다고 하자. 이때 자기가 직접 만든 엉성한 시점과 상태(On-policy trajectory) 위에서 "내가 만든 틀렸구..
강화학습 공부 시작
강화학습 공부 시작
Reinforcement Learning
2026.08.17 20:08
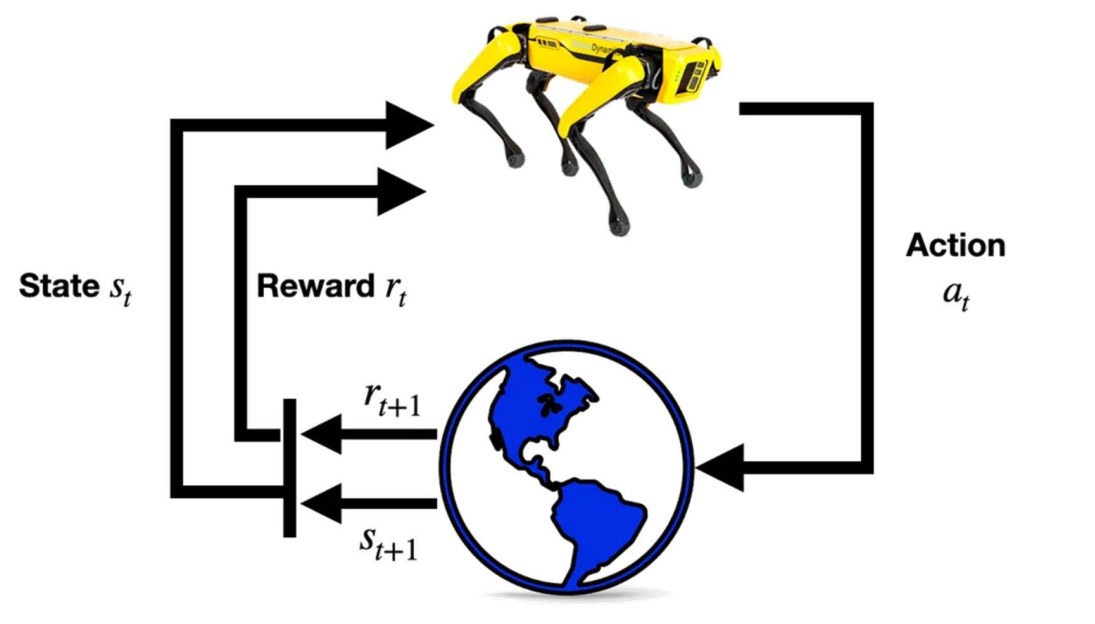
나도 로봇 가지고 놀고 싶어 이제 한 물 간 기법 중에 하나라고 생각했습니다.하지만 젠슨 황 회장님께서 Physical AI를 선언하셨습니다. LLM이 등장하고 부터Post training등이 다시 대두되면서, 거기에 로봇 파워에 힘입어 개같이 부활한 개념이죠. 강화학습은 어떤 학습을 위해 만들어진걸까요?? 지금에서 action을 로봇에 대응이 되지만이전부터 action은 그냥 행위입니다. 알파고 같은 경우는 바둑돌을 어디에 놓는지가 해당되죠. '에이전트'가 잘 행동하게 하자 딥러닝은 network가 핵심 엔진이라고 한다면강화학습은 network가 물론 될 수 있지만, 에이전트라는 핵심 단어로 해서 에이전트를 잘 학습시켜보자는게 key입니다. 위 그림에서 지구가 에이전트이자 polic..
<궁금증> Flat Minima
<궁금증> Flat Minima
https://neverthe1ess.tistory.com/269 [Coursera] Gradient Descent / Deep Learning Specialization우리는 Cost Function $J(w, b)$를 최소화 하는 w, b를 찾는 것이 목표라고 했었죠. 하지만 여기서 의문이 하나 들었어요. 왜 굳이 Sigmoid인가? Threshold(임계값)로 자르면 안되나? 저는 이 궁금증이 생겼을neverthe1ess.tistory.com 딥러닝을 배울 때 우리는 Gradient Descent를 배우죠.기울기를 하강하는 방향으로 쭉 내려가서 우리는 무엇에 다다르게 했었나요? Minimum, 최솟값이었죠. 학습을 한다는 건 우리가 구한 loss의 값을 최소로 줄인다는 겁니다. 0이면 얼마나 좋겠..
MY GALLERY
image